Araştırma
Pekiştirmeli Öğrenme & Karar Sistemleri
Değişen koşullara uyum sağlayan karar politikaları, ödül tasarımı, simülasyonda eğitim ve sahaya güvenli aktarım.

Ne üzerinde çalışıyoruz
- 01Ödül tasarımı ve ödül manipülasyonunun (reward hacking) tespiti
- 02Simülasyonda eğitip sahaya aktarma; simülasyon–gerçeklik farkının kapatılması
- 03Dil modelleriyle birlikte çalışan karar politikaları
- 04Güvenli keşif: sistemin öğrenirken geri alınamaz bir hata yapmasının önlenmesi
- 05Çok adımlı kararlarda başarının nasıl ölçüleceği ve politika regresyonunun yakalanması
Neden bu alanda çalışıyoruz
Bazı problemlerde doğru cevap sabit değil: karşı taraf da davranışını değiştiriyor. Statik bir kural seti ya da bir kez eğitilmiş bir sınıflandırıcı bu durumda öngörülebilir hale geliyor, öngörülebilir olan da aşılıyor.
Pekiştirmeli öğrenme bu problem sınıfına yanıt veriyor, ama kendi zorluklarını getiriyor: ödül yanlış tasarlandığında sistem istediğiniz şeyi değil ödülü optimize ediyor. Çalışmalarımızın ağırlığı bu yüzden ödül tasarımı ve güvenli keşif üzerinde.
Araştırma projelerimizden
Bu alandaki iki destekli projemiz de aynı fikirden çıkıyor: koruma stratejisi sabit kaldığında öngörülebilir oluyor. Hem yazılım koruma hem tehdit tespiti sistemlerimiz, karşılaştıkları duruma göre stratejilerini pekiştirmeli öğrenmeyle güncelliyor.


Diğer araştırma alanları
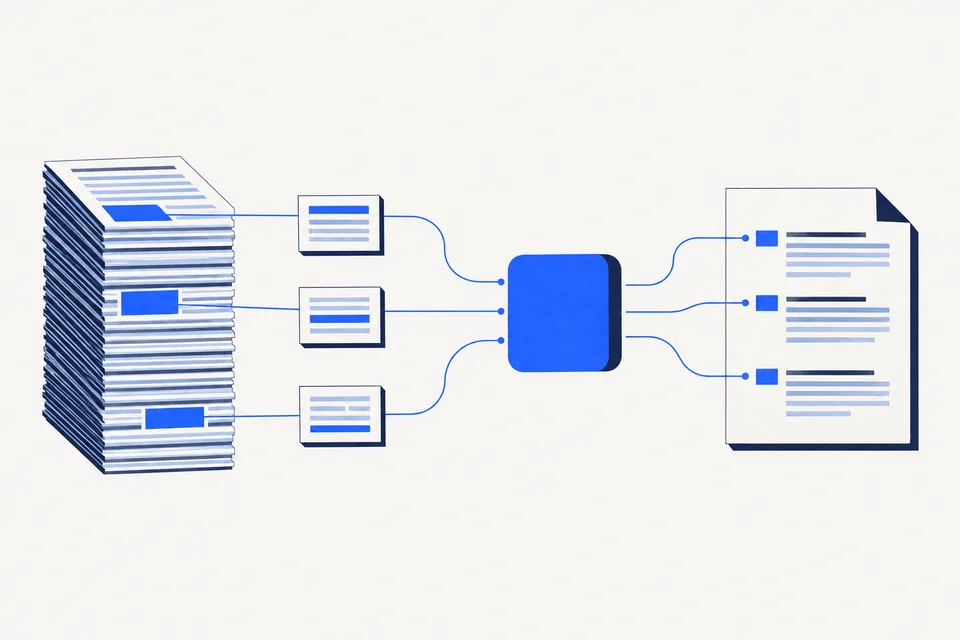
Üretken Yapay Zeka & LLM
RAG mimarileri, alan uyarlaması ve ince ayar, küçük modellere damıtma, Türkçe değerlendirme setleri ve şirket içi kurulum.
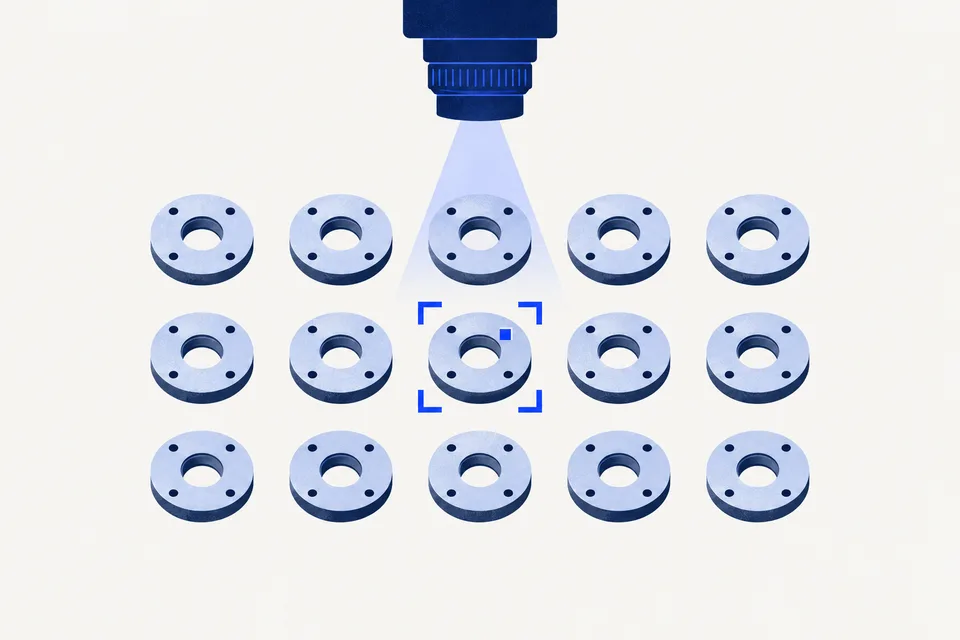
Bilgisayarlı Görü
Nesne tespiti ve takip, video anlama, görsel-dil modelleri, belge zekası ve OCR, uç cihazda gerçek zamanlı çalıştırma.
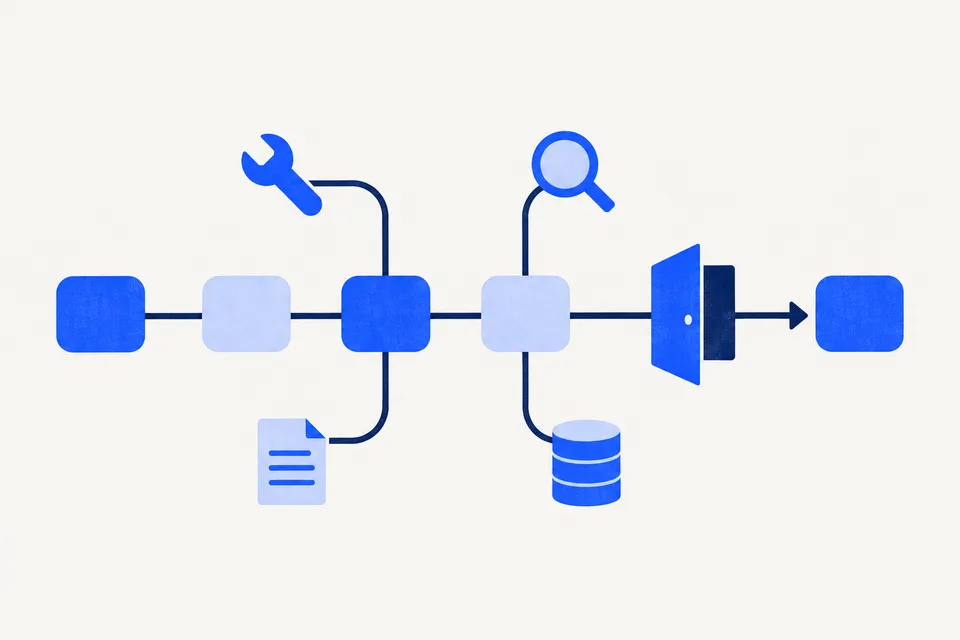
Yapay Zeka Ajanları
Araç kullanımı, çok adımlı planlama ve çoklu ajan orkestrasyonu; MCP entegrasyonu, insan onaylı iş akışları ve güvenlik bariyerleri.
MLOps & Model Operasyonları
Değerlendirme altyapısı, gözlemlenebilirlik, halüsinasyon ve regresyon takibi, sürekli yeniden eğitim.
Yapay Zeka Güvenliği & Mahremiyet
Çekişmeli saldırılara dayanıklılık, komut enjeksiyonu savunması, veriyi paylaşmadan öğrenme ve model gizliliği.


Yapay zeka projeniz için teknik değerlendirme
Projenizin fizibilitesi, riskleri ve takvimi teknik görüşmede değerlendirilir.